SOMMAIRE
Un audit technique SEO reste l’un des moyens les plus efficaces pour mesurer l’état de santé d’un site. Il recense les pages inaccessibles, les redirections défaillantes, les balises manquantes ou les ralentissements, et permet de vérifier qu’aucune régression n’apparaît au fil des évolutions. Google le décrit lui-même comme un exercice utile, à condition que chaque constat soit rapporté au site concerné avant de devenir une recommandation. C’est sur ce point que les audits divergent : réalisé de l’extérieur, à partir d’outils d’exploration et de bases de données SEO, un audit relève des écarts à des règles, sans disposer des données qui permettraient de savoir si ces écarts pèsent réellement sur la visibilité du site.
Notre article sur les audits gratuits SEO et GEO décrivait une pratique commerciale, le démarchage fondé sur des rapports produits en série. Celui-ci s’attache à la méthode : ce que les outils permettent d’établir sans accès aux données d’un site, ce qu’ils ne peuvent pas évaluer correctement, et la manière de confirmer ou d’écarter chaque alerte. Il s’appuie sur la documentation de Google, sur les déclarations publiques de ses équipes et sur les situations que nous rencontrons dans le cadre de nos réalisations. Les sources sont regroupées en fin d’article.
Deux points de vue sur un même site
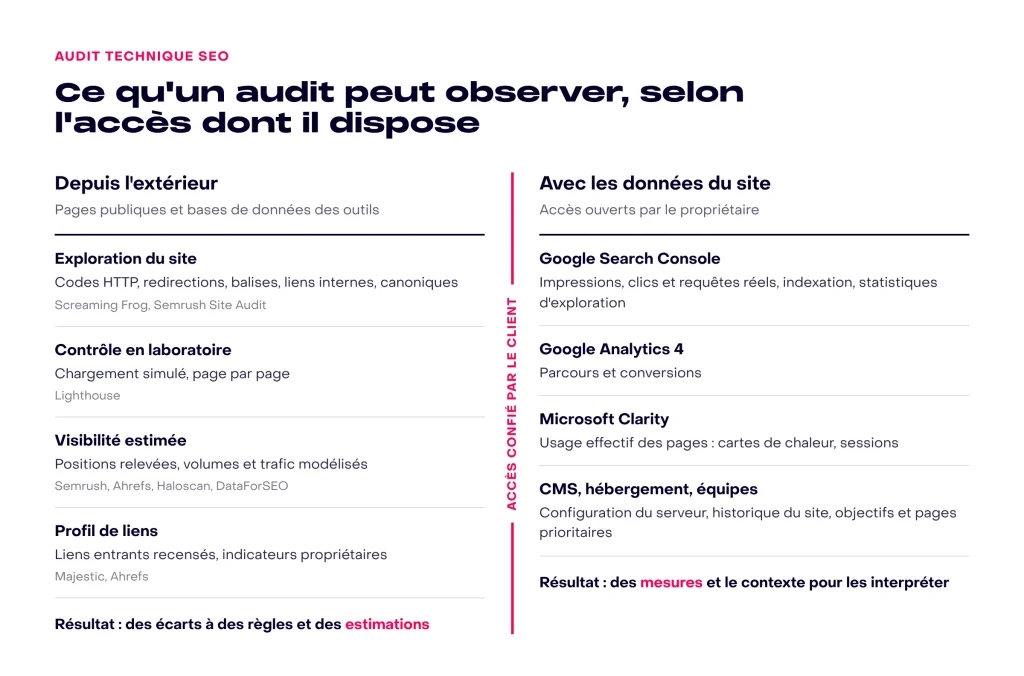
Les outils mobilisés par un audit n’observent pas le site depuis le même endroit. La plupart travaillent à partir de ce qui est publiquement accessible ; un seul groupe s’appuie sur les données que le propriétaire du site a la possibilité de partager.
| Rôle | Outils | Ce qu’ils produisent | Accès confié par le client |
|---|---|---|---|
| Exploration du site (crawl) | Screaming Frog, module Site Audit de Semrush | Codes de réponse HTTP, redirections, balises, liens internes, balises canoniques des pages accessibles | Non |
| Contrôle d’une page en laboratoire | Lighthouse | Scores de performance, de SEO et d’accessibilité calculés sur un chargement simulé, page par page | Non |
| Performance mesurée sur les visites réelles | PageSpeed Insights (données CrUX), rapport Core Web Vitals de la Search Console | Core Web Vitals issus des visites des utilisateurs de Chrome, lorsque le trafic est suffisant | Non pour PageSpeed Insights, oui pour la Search Console |
| Visibilité estimée et mots-clés | Semrush, Ahrefs, Haloscan ; DataForSEO (API de données) | Positions, volumes de recherche, trafic estimé, concurrents | Non |
| Profil de liens | Majestic, Ahrefs | Liens entrants, indicateurs propriétaires de qualité et de quantité des liens | Non |
| Données réelles du site | Google Search Console, Google Analytics 4, Microsoft Clarity | Impressions, clics et requêtes ; état d’indexation et statistiques d’exploration ; parcours et conversions ; comportements (cartes de chaleur, sessions) | Oui |
Les cinq premières familles décrivent le site tel qu’il apparaît de l’extérieur. Seule la dernière renseigne sur ce qui s’y passe réellement, et elle suppose que le propriétaire du site en ouvre l’accès. Google a formalisé cette distinction en juin 2026, dans une page consacrée aux outils, services et conseils SEO tiers : ces outils n’ont pas accès à ses données internes de classement et ne peuvent garantir aucun résultat, et Google recommande, qu’un outil tiers soit utilisé ou non, de s’appuyer sur la Search Console, qui fournit des données issues directement de son moteur [1].
Les estimations des outils tiers ne sont pas dépourvues de méthode. Ahrefs calcule par exemple le trafic organique d’un site à partir de ses positions, du volume de recherche de chaque mot-clé et d’un taux de clic estimé pour chaque position. L’éditeur a comparé ces estimations aux données de la Search Console sur le trafic américain de 1 635 sites : l’écart médian atteignait 49,52 %, avec des erreurs inférieures à 5 % pour certains sites et supérieures à 1 000 % pour d’autres [2]. Une estimation de ce type permet de comparer des ordres de grandeur, par exemple la position d’un site face à ses concurrents ; elle ne permet pas de mesurer l’audience d’un site donné.
Le rôle d’un audit technique, selon Google
Dans une vidéo publiée par Google Search Central le 6 novembre 2025, Martin Splitt, membre de l’équipe Search Relations de Google, rappelle l’objectif d’un audit technique : s’assurer qu’aucun problème n’empêche l’exploration ou l’indexation des contenus, plutôt que produire une liste de constats. Il décrit une démarche en trois étapes, qui consiste à identifier les problèmes potentiels à l’aide des outils et des consignes de Google, à établir un rapport adapté au site concerné, puis à formuler des recommandations hiérarchisées selon leur effet et l’effort qu’elles demandent. Il invite surtout à ne pas suivre les outils aveuglément et à vérifier que chaque constat a un sens pour le site audité, en citant l’exemple d’un nombre élevé d’erreurs 404, qui n’est pas toujours le signe d’un problème [3].
La première étape est celle que les outils automatisent le mieux. Les deux suivantes supposent de connaître le site, sa technologie, son historique et ses objectifs. Les scores attribués par les outils relèvent de la même logique : en août 2023, John Mueller, Search Advocate chez Google, indiquait que le moteur n’utilise pas les scores des outils tiers pour classer les pages, tout en reconnaissant qu’ils peuvent aider à repérer de vrais problèmes, à condition de comprendre comment ils sont calculés [4].
Les alertes fréquentes, confrontées aux données réelles
Le tableau suivant reprend les alertes les plus courantes des audits réalisés de l’extérieur. Pour chacune, il indique ce qu’en dit Google, la situation dans laquelle l’alerte correspond à un problème réel et la donnée qui permet de trancher. La plupart de ces alertes peuvent être fondées ; aucune ne l’est par principe.
| Alerte | Ce qu’en dit Google | Problème réel lorsque… | Donnée qui tranche |
|---|---|---|---|
| Pages en erreur 404 | La plupart des erreurs 404 ne méritent pas de correction, car elles ne nuisent ni à l’indexation ni au classement [5] | l’URL figure dans le sitemap, reçoit des liens entrants ou du trafic | Rapport « Indexation des pages » de la Search Console, liens entrants, Google Analytics 4 |
| Erreurs serveur 5xx | Elles conduisent Google à ralentir l’exploration ; les URL déjà indexées sont conservées, puis retirées si l’erreur persiste [6] | l’erreur persiste ou touche des pages importantes | Requête curl, rapport « Statistiques sur l’exploration », journaux du serveur |
| Chaînes de redirection | Les robots de Google suivent par défaut jusqu’à dix redirections successives [6] | la chaîne forme une boucle ou aboutit à une erreur | Rapport « Indexation des pages », outil d’inspection d’URL |
| Meta description absente ou dupliquée | Google construit l’extrait principalement à partir du contenu de la page [7] et n’utilise pas la balise pour classer les pages [8] | la page reçoit des impressions et son extrait dessert le clic | Rapport « Performances » de la Search Console |
| Balise H1 absente ou multiple | Un site se classe aussi bien sans balise H1 qu’avec plusieurs [9] | la structure des titres gêne la lecture ou l’accessibilité | Audit d’accessibilité (RGAA) |
| Ratio texte/HTML, nombre de mots | Ni l’un ni l’autre n’est un critère de classement [10] [11] | jamais en tant que tel | Aucune |
| Liens « toxiques » | Google considère cette notion comme une construction des outils SEO [12] | Google a appliqué une action manuelle | Rapport « Actions manuelles » de la Search Console |
| Plusieurs pages sur une même requête | Plusieurs pages classées sur une requête ne posent pas de problème ; l’absence de page classée en pose un [13] | aucune page ne se positionne | Rapport « Performances », croisement des requêtes et des pages |
| Budget d’exploration | Le guide de Google vise les sites de plus d’un million de pages, ou de plus de 10 000 pages dont le contenu change chaque jour [14] | le site entre dans ces catégories | Rapport « Statistiques sur l’exploration » |
| Performance mesurée en laboratoire | Les données de laboratoire et de terrain mesurent des choses différentes et peuvent diverger fortement [15] | les données de terrain, évaluées au 75e centile, sont insuffisantes sur les pages qui comptent | Données CrUX de PageSpeed Insights, rapport Core Web Vitals |
| Balise canonique incohérente | L’outil d’inspection d’URL distingue la canonique déclarée et celle que Google a retenue [16] | Google retient une autre URL pour une page stratégique | Outil d’inspection d’URL |
| Trafic estimé en baisse | Une estimation dérivée de positions et de volumes modélisés [2] | les clics réels baissent sur une période comparable | Rapport « Performances » de la Search Console |
La dernière colonne explique pourquoi un même rapport peut conduire à des conclusions opposées. Sans accès à ces données, l’auditeur ne peut que constater l’écart à une règle. Avec elles, il peut mesurer si cet écart a une conséquence pour le site, et décider s’il mérite d’être traité.
Quand l’environnement d’audit produit l’alerte : les erreurs 503
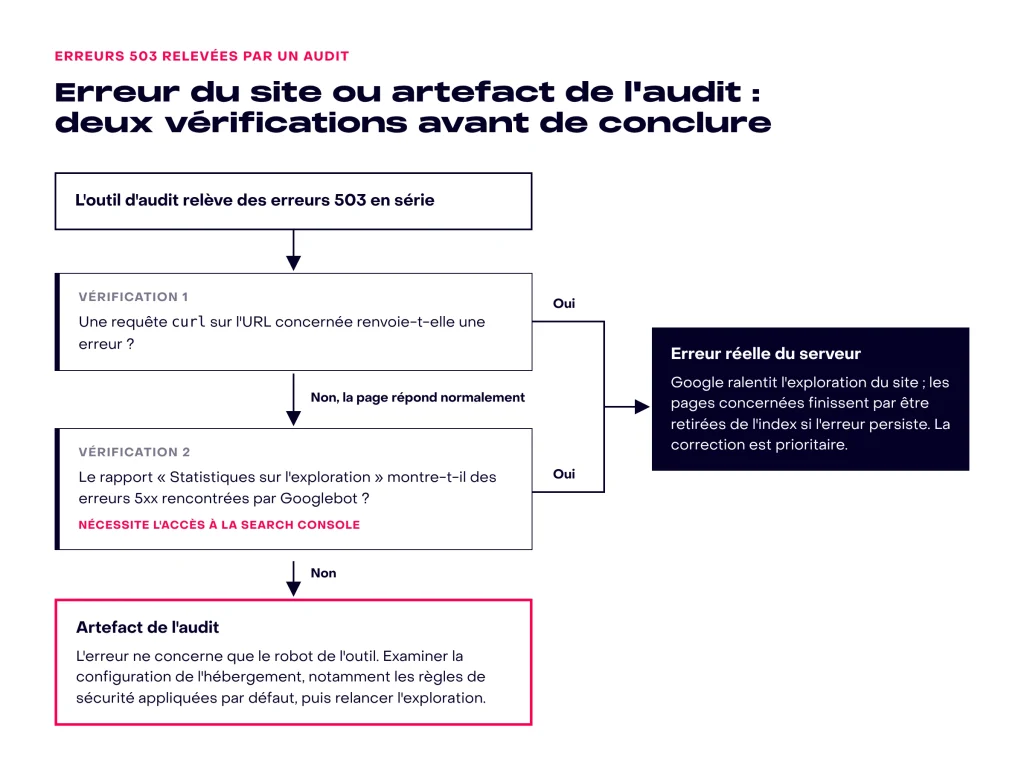
Une erreur serveur relevée pendant l’exploration ne signale pas nécessairement une défaillance du site. Elle peut provenir des conditions dans lesquelles l’audit a été réalisé. Nous l’avons constaté dans le cadre de nos réalisations sur des sites hébergés chez o2switch : des règles de sécurité appliquées par défaut par l’hébergeur ont été identifiées comme la source des erreurs 503 relevées par les robots d’audit, et la désactivation de la règle concernée a permis de fiabiliser les audits. La situation reste isolée, mais lorsqu’un rapport fait apparaître des erreurs 503 en série, la configuration de l’hébergement est une piste à examiner avant de mettre en cause le site lui-même.
La distinction a une portée directe. Une erreur 5xx rencontrée par Googlebot conduit Google à ralentir l’exploration, et les pages concernées finissent par être retirées de l’index si l’erreur persiste [6]. Une erreur rencontrée uniquement par le robot d’un outil tiers relève en revanche de l’audit, et non du référencement du site. Lorsqu’un audit signale ce type d’erreur, nous vérifions l’état réel de la page par une requête curl avant de retenir l’alerte, puis nous contrôlons dans le rapport « Statistiques sur l’exploration » de la Search Console si Googlebot rencontre les mêmes réponses. Cette seconde vérification n’est possible qu’avec un accès aux données du site.
La page positionnée n’est pas toujours la page prévue
Un audit externe associe les requêtes aux pages à partir des relevés de positions de l’outil, à un instant donné. Le rapport « Performances » de la Search Console permet de vérifier, requête par requête, quelles pages reçoivent réellement les impressions et les clics. Cette vérification évite deux erreurs d’interprétation de nature différente.
La première consiste à voir un dysfonctionnement dans un choix du moteur. Les actions menées pour positionner une page précise sur une requête n’en garantissent pas le résultat, car Google reste seul à décider de la page qu’il présente. Nous le constatons dans le cadre de nos réalisations, par exemple lorsqu’une page d’accueil se positionne durablement à la place de la page dédiée à un service. Le site est alors correctement positionné, simplement pas sur la page attendue, et la décision consiste à évaluer si cette situation dessert réellement le visiteur avant d’engager des modifications. John Mueller rappelle d’ailleurs que plusieurs pages d’un même site classées sur une requête ne constituent pas un problème, alors que l’absence de page classée en est un [13].
La seconde erreur consiste à prendre une modélisation pour un fait. L’un de nos clients a récemment reçu un audit réalisé de l’extérieur par une agence, selon lequel sa page de contact se positionnait sur les requêtes à plus forte valeur pour son activité. Nos tests et les contrôles effectués dans la Search Console ont montré qu’il s’agissait d’un artefact : la page de contact n’est jamais la page associée à ces requêtes. Un audit automatisé, parfois complété par une analyse produite à l’aide d’une intelligence artificielle, peut ainsi aboutir à des conclusions sans fondement dans les données du site, présentées avec la même assurance que des constats vérifiés.
Le rythme d’activité, une donnée invisible de l’extérieur
Certaines variations ne s’observent qu’avec les données du site. Dans la Search Console, les sites d’activités qui ne travaillent pas le week-end, d’entreprises qui s’adressent à des professionnels ou de certains organismes institutionnels présentent souvent des courbes en dents de scie très nettes. Les impressions, concentrées sur la semaine de travail, chutent le samedi et le dimanche ; les clics suivent la même évolution, et les positions varient selon ce même cycle. Nous le constatons dans le cadre de nos réalisations, avec des profils très marqués selon les domaines d’activité.
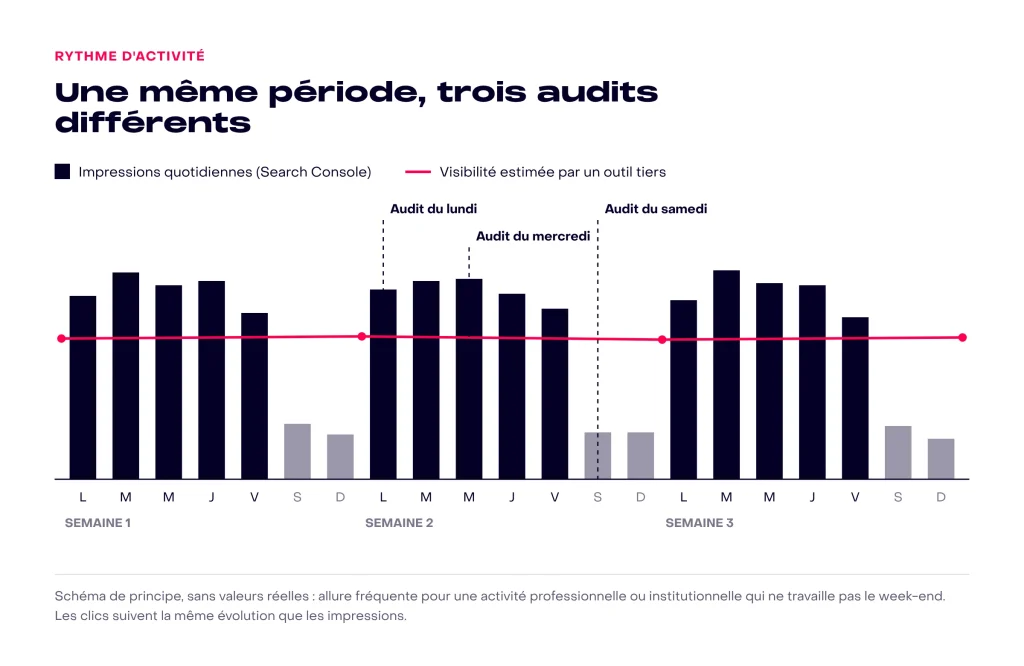
Cette périodicité a une conséquence directe sur l’analyse : un audit réalisé un lundi, un mercredi ou un samedi ne repose pas sur la même situation, et la comparaison de deux périodes n’a de sens que si elles couvrent les mêmes jours de la semaine. Un graphique de visibilité issu d’un outil tiers, construit à partir de relevés de positions et d’estimations, ne restitue pas ces variations, et le trafic modélisé par une solution SEO n’atteint pas ce niveau de précision. Cette lecture ne peut être faite que de l’intérieur.
De l’alerte à la décision
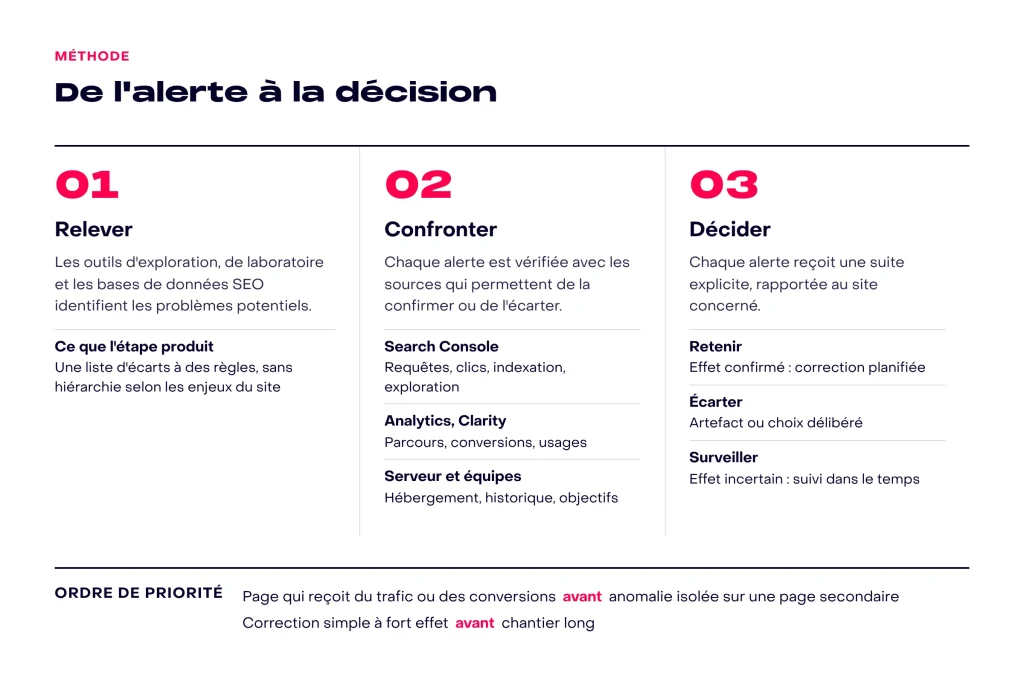
Un audit SEO fondé sur les données réelles reprend le relevé des outils, puis confronte chaque alerte aux sources qui permettent de la confirmer ou de l’écarter. La Google Search Console fournit les impressions, les clics, les requêtes, l’état d’indexation et les statistiques d’exploration ; Google Analytics 4 mesure les parcours et les conversions ; un outil d’analyse comportementale comme Microsoft Clarity restitue l’usage effectif des pages. S’y ajoutent l’accès au CMS et à l’hébergement, l’historique des évolutions du site et les échanges avec les équipes sur leurs objectifs, qui déterminent les pages prioritaires : un site institutionnel, une boutique en ligne et un site de recrutement n’ont ni les mêmes pages stratégiques, ni les mêmes indicateurs de réussite.
La hiérarchisation vient ensuite. Une alerte confirmée sur une page qui reçoit du trafic ou des conversions passe avant une anomalie isolée sur une page secondaire, et une correction simple à fort effet avant un chantier long. Nous privilégions pour notre part les corrections au gain rapide, menées en parallèle des évolutions de fond, plus longues à produire leurs effets. Le relevé automatisé conserve toute sa place dans cette démarche, au moment du diagnostic puis pour vérifier qu’aucune régression n’apparaît après les évolutions du site.
Pour une organisation qui reçoit un audit réalisé de l’extérieur, la même démarche peut s’appliquer sans attendre : reprendre les alertes présentées comme prioritaires, vérifier dans la Search Console si les pages et les requêtes citées correspondent à la réalité du site, et demander, pour chaque recommandation, la donnée qui la justifie. Les signaux qui permettent de repérer un rapport produit en série sont détaillés dans notre article sur les audits gratuits SEO et GEO.
Sources
- Google Search Central, Google Search’s guidance on using third-party SEO tools, services, and advice, juin 2026 ; voir aussi Search Engine Land.
- Ahrefs, How Accurate Are the Search Traffic Estimations in Ahrefs ?, 2022, et méthode de calcul du trafic organique.
- Search Engine Journal, Google Warns Against Relying On SEO Audit Tool Scores, novembre 2025 (vidéo de Martin Splitt, Google Search Central).
- Search Engine Land, article sur l’usage des scores des outils SEO par Google, août 2023 (vidéo « Ask Googlebot » de John Mueller).
- Aide Search Console, Erreurs 404 (page introuvable).
- Google, How HTTP status codes affect Google’s crawlers.
- Google Search Central, Contrôler les extraits dans les résultats de recherche ; voir aussi Search Engine Journal.
- Search Engine Journal, Are Meta Descriptions A Google Ranking Factor ?.
- Search Engine Land, Multiple H1s won’t get in the way of your SEO, Google says, octobre 2019.
- Search Engine Roundtable, Google : Text To HTML Ratio Makes No Sense For SEO, août 2023.
- Search Engine Roundtable, Google : Word Count Is Not A Ranking Factor, août 2019.
- Search Engine Roundtable, Google’s John Mueller Blasts The Concept Of Toxic Links, Again, mai 2024.
- Search Engine Journal, Google Answers SEO Question About Keyword Cannibalization.
- Google, Optimize your crawl budget.
- web.dev, Why lab and field data can be different.
- Search Engine Journal, What Is A Canonical URL ? ; Aide Search Console, outil d’inspection d’URL.
Mis à jour le